GEMM 优化总结
从 Naive 到 Double Buffering,七步优化,10.6× 加速比。
测试平台:RTX 5080 (Blackwell, sm_120, 84 SM),M=N=K=4096
前言:网络上有非常多优质的GEMM优化博客,本篇笔记不再对各版本优化的详情再做解释,个人水平也有限,在优化时也参考了他人的博客和源码。
此篇博客主要为各版本做个总结,并对SGEMM优化中的主线做一个阐述,目的是能把SGEMM说明白,把各种瓶颈和问题说明白。
调用cuda core计算的数据精度为fp32,误差~1e-4。
各版本做了什么
ex3 Naive — 起步
每个线程从 HBM 直读一整行和整列做点积,无任何数据复用。纯访存瓶颈,算术强度极低。
ex4 Tiled — 引入 Shared Memory
把矩阵切成 BK×BK 小块,一次搬进 shared memory,block 内线程共享复用。从 HBM 读 1 次、shared 读 BK 次。BK=16 时 barrier 太多反而慢(47.6ms),BK=32 才见效。
ex5 Coarsening — 线程复用
每线程负责 2×2 输出,K-tile 从 16 扩大到 32。减少 block 总数、增加每线程计算量,shared 仍 8KB,occupancy 满。
ex6 STRIDE=4 — 向量化加载
STRIDE 扩到 4,用 float4 一次读 128 bit 数据。但 BK 被迫变成 64 → shared 32KB → occupancy 掉一半 → 整体倒退。
ex7 Register Tiling — 减少 Shared 读
把 shared 里 BK×BK 再切 RK×RK 子块搬进寄存器。Shared 读量减少为 1/RK,内层循环从寄存器计算,shared 延迟被摊薄。在 occupancy 受限(32KB shared)的情况下仍跑到 5.2ms。
ex8 Register Prefetching — 完全重构
完全放弃二维线程映射,改用 1D 线程 + warp-level tiling。四大变化:
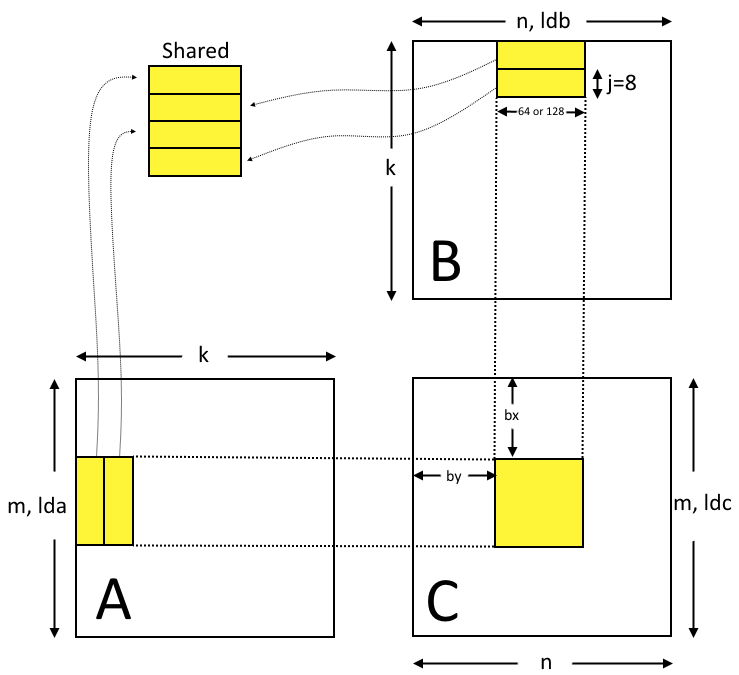
- BM/BN/BK 解耦:大 tile (128×128) + 小 BK (8) → shared 仅 8KB,occupancy 拉满
- B 转置存储:消除所有 bank conflict
- Global→Reg Prefetch:先发射 LDG tile K+1,不等完成直接算 tile K,500 cycle HBM 延迟被吞掉
- Shared→Reg 乒乓:两组寄存器交替预取和计算,18 cycle shared 延迟被覆盖
ex9 Double Buffering — 省 Barrier
两套 shared buffer(16KB),读 buffer[cur] 和写 buffer[nxt] 同时进行,无需中间 __syncthreads。每 K 迭代从 2 次 barrier 降到 1 次,提升 6.4%。
方法论总结
CUDA GEMM 优化是一个从应用层到硬件微架构的全栈工程。核心方法论可以归结为:
- 提升算术强度:通过分块(Block Tile → Warp Tile → Register Tile)逐层提高数据复用率
- 隐藏访存延迟:通过双缓冲/流水线让计算与数据搬运重叠执行
- 最大化带宽利用:向量化访存、消除 Bank Conflict、利用 Broadcast
- 精细指令调度:寄存器分配、指令交错、Reuse Cache
每一层优化都在"搬运"与"计算"的竞赛中为计算争取更多优势。理解了这套方法论,你不仅能写出高效的 GEMM kernel,也能将相同的思维迁移到其他访存密集型 CUDA 算子的优化中。
自测十问
Q1:GEMM 分块后算术强度从 0.25 提升到 32 FLOPs/Byte 的推导过程?
Naive 实现(无分块,每个线程从 HBM 读):
每输出 1 个元素:读 A 的 K 个 + B 的 K 个 = 2K 个 float = 8K Bytes
做了 K 次 FMA = 2K FLOPs
算术强度 = 2K / 8K = 0.25 FLOPs/Byte
Shared Memory Tiling(BM×BK + BK×BN tile):
一个 block 加载:BM×BK + BK×BN = BK×(BM+BN) 个 float 从 HBM
一个 block 计算:BM×BK×BN×2 FLOPs(BM×BN 个输出 × BK 次 FMA × 2)
HBM 算术强度 = BM×BN×BK×2 / (BK×(BM+BN)×4) = BM×BN / (2×(BM+BN))

BM=BN=128:128²/(2×256) = 16384/512 = 32 FLOPs/Byte
每个 byte 从 HBM 搬到 shared 后能产生 32 次浮点运算,是 naive 的 128 倍。
Q2:朴素实现、Shared Memory 分块、线程分块各自的性能瓶颈?
阶段瓶颈表现NaiveHBM 带宽每个 FMA 都要读 8 bytes HBM,算力利用率 < 1%Shared Memory TilingShared Memory 带宽 + 同步开销数据从 HBM 搬到了 shared,但每 k 迭代仍读 shared(20 cycle),还有 __syncthreads 开销Register TilingHBM 延迟暴露shared 读减少了,但没有 prefetch,500 cycle HBM 延迟串行等待,occupancy 不够时无法掩盖Prefetch + Double Buffer算力上限延迟全被掩盖后,瓶颈回到 SM 的 FFMA 吞吐——已经做到极致了
Q3:独立实现一个包含 Shared Memory Tiling + Register Tiling 的 SGEMM kernel 的关键步骤?
- 定义 tile 参数:BM、BN、BK(block tile),TM、TN(thread tile)
- Global → Shared:block 内线程协作把 BM×BK 和 BK×BN 从 HBM 搬运到
__shared__ float As[BM][BK], Bs[BN][BK] - Shared → Register:每线程把 TM×BK 的 As 片段 + TN×BK 的 Bs 片段搬进 float4 寄存器组
- 内层 FFMA:双层循环——外层 kk over BK step 1,内层展开 16 个 float4 FMA
- Register → Global:累加器写回 C
ex7 就是这个结构的完整实现(TILE=16, STRIDE=4, RK=4)。
Q4:外积(Outer Product)相比内积为何能提高 Shared Memory 复用率?
内积(行列点积):
C[i][j] = sum_k A[i][k] × B[k][j]
每算一个 C[i][j] 需要读一整行 A 和一整列 B,A 的同一行被 BN 个线程重复读
外积(列×行):
for k: C[:,:] += A[:,k] ⊗ B[k,:]
A 的一列和 B 的一行做外积,更新整个 C tile
A[:,k] 被 block 内所有线程共享一次,B[k,:] 同理
在 shared memory 中,外积方式的 A 和 B 各读一次就能更新整个 BM×BN 输出块,消除了线程间的重复读取。
Q5:双缓冲流水线中 LDG / FFMA / STS 的时序重叠关系?
时间轴 →
───────────────────────────────────────────────────────────

tile 0:  [LDG0]──[STS0]──[__sync]──[FFMA0]────────────────
tile 1:            [LDG1]────────────────[STS1]──[__sync]──[FFMA1]
tile 2:                                  [LDG2]────────────────[STS2]──[__sync]──[FFMA2]

关键重叠:
  FFMA0 ∥ LDG1    ← LDG tile 1 和计算 tile 0 同时进行
  FFMA1 ∥ LDG2    ← LDG tile 2 和计算 tile 1 同时进行
- LDG:~500 cycle
- STS:~20 cycle
- FFMA:计算主体
- 双缓冲的价值:FFMA(tile k) 和 LDG(tile k+1) 完全重叠 → HBM 延迟被 100% 隐藏
Q6:Nsight Compute 中 Stall Long Scoreboard 和 MIO Throttle 的含义?
指标含义典型原因Stall Long Scoreboardwarp 在等 Global Memory 数据到位(LDG 发出后在 scoreboard 挂起)算术强度不够、没有 prefetch、occupancy 太低Stall MIO Throttlewarp 在等 MIO 单元(访存流水线),shared memory 读写排队shared memory bank conflict、shared 访问量太大Stall Short Scoreboardwarp 在等 shared memory 数据(LDS 指令发出后等 ~20 cycle)没有 register prefetch 乒乓缓冲
优化方向:
- Stall Long Scoreboard 高 → 加 prefetch(LDG 提前发射)
- Stall MIO Throttle 高 → 检查 bank conflict、减少 shared 访问
- Stall Short Scoreboard 高 → 加 shared→register 乒乓
Q7:Shared Memory Bank Conflict 的产生条件和 3 种解决方案?
产生条件:同一个 warp 内不同线程访问 shared memory,两个及以上地址落在同一个 bank(共 32 banks),且不是同一个地址(broadcast)。
3 种解决方案:
- Padding——加一列填充打破对齐
__shared__ float As[BM][BK + 1]; // +1 偏移打破 32-bank 对齐
- 转置存储(ex8/ex9 的做法)
B 从 N×K(行主序)读入后转置存为 K×N(列主序)
计算时按 K 方向 float4 读 → 4 个连续 bank,无冲突
- Swizzle——地址交织
物理地址 = (逻辑地址 xor (逻辑地址 >> 3)) — XOR 模式打散 bank 映射
CUTLASS/cuBLAS 内部常用。
Q8:为什么 4×8 的 Warp Tile 形状优于 1×32?
Warp 有 32 个线程。1×32 是把 32 线程排成一行,4×8 是排成 4 行 8 列:
1×324×8A shared 读只有 1 行被读4 行共享 AB shared 读32 个分散地址8 列,A 复用更充分Bank conflict连续访问易对齐 → 高冲突行列分散 → 更容易避开
核心原因:矩阵乘法是二维的,方阵 warp tile 更均衡地利用 A 和 B 的数据复用。
Q9:给定 TM/TN/BM/BN 参数如何计算寄存器用量和 occupancy?
寄存器用量公式:
reg_count = A_buffer + B_buffer + C_accumulator

A_buffer = TM × 1(float4 = 4 floats/reg,但寄存器存的是 float,每个 float 占 1 reg)
         = TM 个 register
B_buffer = TN 个 register
C_acc    = TM × TN 个 register(TM×TN 个 float 累加器)

总计 regs ≈ TM + TN + TM×TN

例:TM=8, TN=8 → 8 + 8 + 64 = 80 registers
Occupancy 计算:
max_blocks_per_SM = min(
  65536 / (regs_per_thread × threads_per_block),  // 寄存器限制
  max_shared / shared_per_block,                   // shared memory 限制
  2048 / threads_per_block                          // 线程数限制
)

例:80 regs/thread, 256 threads/block:
  寄存器: 65536/(80×256) = 3.2 → 3 blocks → 3×256/2048 = 37.5%
Q10:cp.async 相比传统 LDG+STS 的优势?
传统 LDG + STScp.async (sm_80+)指令LDG → 等完成 → STS一条 cp.async 指令做完同步必须 __syncthreads() 等所有线程Async Pipeline + commit + wait_group,细粒度阶段同步流水线手工 prefetch 到寄存器再 STS硬件 bypass:直接 Global→Shared,不经过寄存器寄存器压力需要额外寄存器暂存 prefetch 数据零寄存器开销(不占 reg file)带宽受限于 LDG/STS 串行独立 async copy engine,与计算完全并行
核心价值:ex8/ex9 用寄存器暂存 prefetch(pref_A, pref_B 各 4 个 float),cp.async 直接省掉这些寄存器,让编译器把寄存器配额全部分给 FFMA。
相关参考:
文章:
代码:
https://github.com/Cjkkkk/CUDA_gemm
https://github.com/NVIDIA/cutlass